1. Bối cảnh & Tầm quan trọng của AI nguồn mở
1.1 Cuộc giằng co chiến lược và nguy cơ bất bình đẳng công nghệ
Cuộc đua Trí tuệ nhân tạo (AI) toàn cầu hiện nay không chỉ diễn ra ở quy mô hạ tầng tính toán (compute) hay sự bứt phá của thuật toán, mà còn nằm ở sự giằng co gay gắt giữa hai mô hình phát triển đối lập: AI độc quyền đóng (Proprietary AI) và AI nguồn mở / mở trọng số (Open-source / Open-weight AI).
Sự thống trị của khu vực tư nhân đang thể hiện rất rõ khi các tập đoàn công nghệ lớn (Hyperscalers) sản xuất hơn 90% các mô hình AI nổi bật. Tuy nhiên, xu hướng thương mại hóa đã khiến các mô hình tiên phong đóng này ngày càng trở thành những “hộp đen” khép kín. Các doanh nghiệp lớn dần cắt giảm sự minh bạch khi giấu kín mã nguồn huấn luyện, cấu trúc tham số, kích thước tập dữ liệu và tài nguyên tính toán sử dụng.
Sự tập trung năng lực AI vào tay một số ít tập đoàn công nghệ thương mại đang tạo ra những lo ngại sâu sắc:
- Nguy cơ phụ thuộc hạ tầng: Các quốc gia và doanh nghiệp phải phụ thuộc hoàn toàn vào cổng kết nối API đám mây do bên thứ ba kiểm soát.
- Bất bình đẳng công nghệ: Chi phí truy cập thương mại đắt đỏ làm gia tăng “độ trễ phát triển” giữa các cường quốc công nghệ và các nước đang phát triển.
- Xói mòn tính công khai khoa học: Sự thiếu minh bạch về dữ liệu và mã nguồn cản trở cộng đồng nghiên cứu độc lập kiểm toán độ an toàn, ảo giác và định kiến thuật toán.
1.2 Luận điểm trung tâm: AI nguồn mở – Động lực dân chủ hóa công nghệ và xác lập chủ quyền
Trái ngược với sự khép kín của các mô hình độc quyền, hệ sinh thái AI nguồn mở đang gia tốc phát triển với quy mô chưa từng có. Toàn cầu hiện ghi nhận hơn 5,58 triệu dự án AI trên GitHub, trong khi số lượng mô hình và tập dữ liệu được chia sẻ trên các nền tảng cộng đồng như Hugging Face đã tăng gấp 3 đến 4 lần chỉ trong vài năm qua.
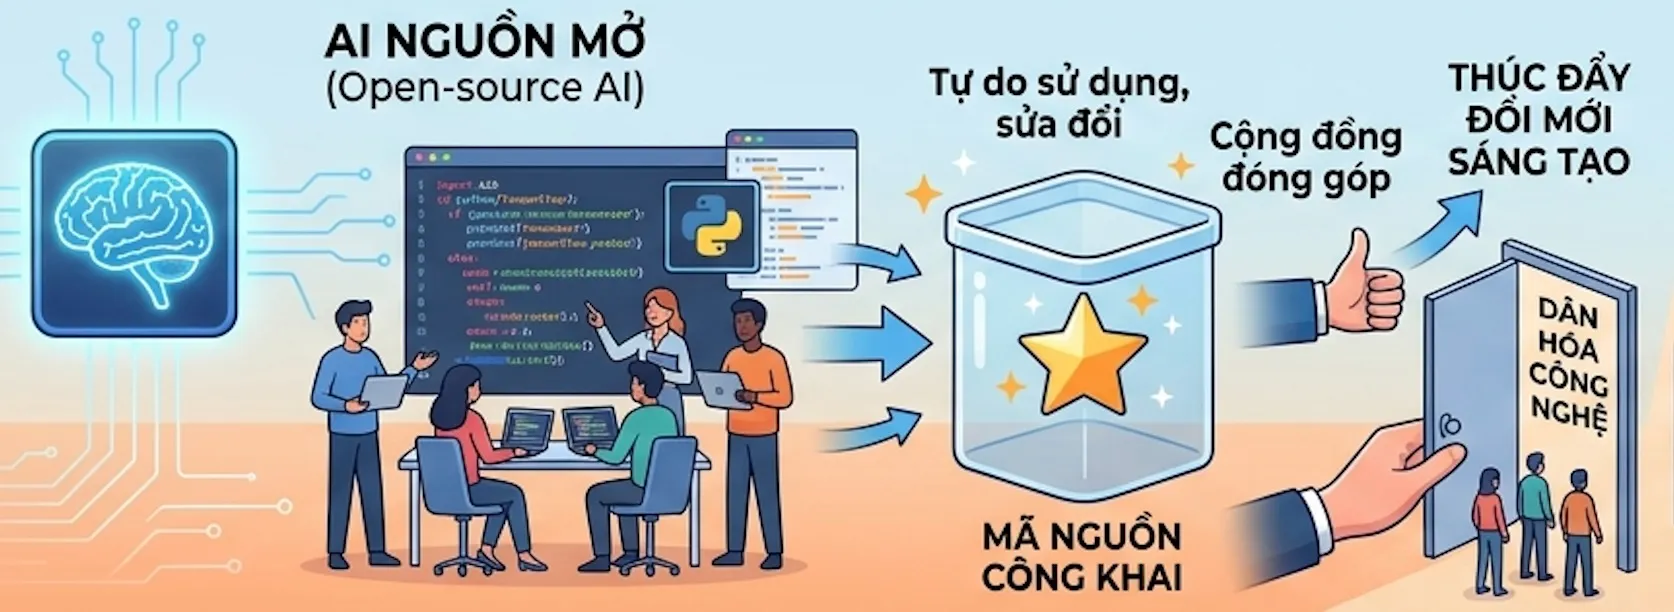
Bản chất của AI nguồn mở vượt xa một phương thức kỹ thuật đơn thuần về chia sẻ mã nguồn hay trọng số mô hình (open weights). Đây chính là động lực cốt lõi để dân chủ hóa công nghệ trên toàn cầu:
- San bằng rào cản gia nhập: Cho phép các doanh nghiệp vừa và nhỏ (SMEs), các công ty khởi nghiệp và cơ quan nghiên cứu tự do tải về, tùy biến (fine-tuning) và triển khai ứng dụng AI trực tiếp trên hạ tầng nội bộ mà không cần đầu tư hàng trăm triệu USD huấn luyện từ đầu.
- Xóa bỏ khoảng cách ngôn ngữ – văn hóa: Các mô hình thương mại đóng chủ yếu tối ưu hóa cho tiếng Anh và các ngôn ngữ lớn. AI nguồn mở tạo điều kiện cho các dự án vùng miền (như SEA-LION tại Đông Nam Á hay AI4Bharat tại Ấn Độ) tự xây dựng mô hình nền tảng thích ứng với đặc thụ văn hóa và ngôn ngữ bản địa.
- Xác lập “Chủ quyền AI” (AI Sovereignty): Nguồn mở là chìa khóa giúp các quốc gia chủ động xây dựng hạ tầng, bảo tồn dữ liệu nội địa và giảm bớt sự phụ thuộc vào các thể chế công nghệ nước ngoài.
2. Định nghĩa và Bản chất của AI nguồn mở (Open-source AI)
2.1 Phân định các cấp độ “Mở” trong AI
Khái niệm “AI nguồn mở” trong thực tế mang tính phổ rộng (spectrum) với nhiều cấp độ tiếp cận khác nhau, từ việc chia sẻ một phần tài nguyên đến công khai toàn bộ quy trình phát triển. Việc phân định rạch ròi các cấp độ này có ý nghĩa then chốt trong công tác kiểm toán, tái lập nghiên cứu và đánh giá mức độ an toàn:
- Mô hình mở trọng số (Open-weight models): Đây là hình thức phổ biến nhất hiện nay trên thị trường (như Llama, DeepSeek, Qwen, Mistral, Gemma, hay OLMo). Nhà phát triển cung cấp cho cộng đồng toàn bộ tham số / trọng số toán học (weights) đã qua huấn luyện cùng kiến trúc mạng (architecture). Cấp độ này cho phép các doanh nghiệp và nhà nghiên cứu dễ dàng tải về, vận hành cục bộ (on-premise) trên hạ tầng riêng, cũng như thực hiện tinh chỉnh (fine-tuning) theo nhu cầu chuyên biệt mà không cần gửi dữ liệu qua các kết nối API thương mại.
- AI nguồn mở toàn vẹn (Full Open-source AI): Đây là cấp độ cao nhất của tính cởi mở, đáp ứng các tiêu chuẩn khắt khe của cộng đồng phần mềm nguồn mở tự do. Ở cấp độ này, nhà phát triển phải công khai minh bạch đầy đủ cả ba thành tố cốt lõi:
- Kiến trúc mô hình (Model architecture) và mã nguồn suy luận (inference code).
- Mã nguồn huấn luyện toàn vẹn (Full training code), bao gồm cả quy trình pre-training và post-training.
- Tập dữ liệu huấn luyện (Training datasets) cùng quy trình làm sạch và lọc trùng lặp (deduplication).
Tuy nhiên, báo cáo Stanford AI Index chỉ ra một thực trạng đáng ngại: trong số 102 mô hình AI nổi bật được phát hành, có tới 81 mô hình hoàn toàn giấu kín mã nguồn huấn luyện, và chỉ có 4 mô hình đạt chuẩn nguồn mở toàn vẹn.
2.2 Thực trạng và xu hướng phát triển hệ sinh thái nguồn mở
Bất chấp xu hướng đóng cửa từ các tập đoàn lớn, hệ sinh thái AI nguồn mở đang ghi nhận quy mô tăng trưởng ấn tượng nhờ sự đóng góp tích cực từ cộng đồng nhà phát triển toàn cầu:
- Bùng nổ dự án trên các nền tảng lập trình: Số lượng dự án AI trên GitHub đã cán mốc 5,58 triệu dự án, đạt tốc độ tăng trưởng 23,7% so với năm trước. Trong đó, có hơn 206.880 dự án đạt từ 10 lượt yêu thích (stars) trở lên. Mặc dù Mỹ vẫn chiếm thị phần lớn nhất về số lượng sao (30 triệu lượt stars tích lũy), hoạt động phát triển nguồn mở đang dần phân bổ rộng khắp tại Châu Âu, Châu Á và các khu vực đang phát triển.
- Sự trỗi dậy của các kho lưu trữ mô hình (Hugging Face): Trên nền tảng Hugging Face, số lượng tải lên các mô hình AI đã tăng hơn gấp 3 lần, trong khi số lượng tập dữ liệu công khai tăng gấp 4 lần. Đáng chú ý, thị phần tải xuống từ các mô hình do các tập đoàn thương mại lớn (như Google, Meta) phát hành đang có xu hướng giảm dần, nhường chỗ cho các mô hình do cộng đồng phi tập trung phát triển (như Sentence Transformers hay cộng đồng BERT).
- Sự suy giảm tính minh bạch gia tăng giá trị cho nguồn mở: Trong khi cộng đồng nguồn mở nỗ lực chia sẻ tài nguyên, các mô hình thương mại đóng hàng đầu ngày càng trở nên khép kín. Chỉ số Tính minh bạch mô hình nền tảng (FMTI) đánh giá các nhà phát triển lớn đã giảm từ điểm số trung bình 58 xuống còn 40. Tương tự, chỉ số Openness Index ghi nhận hầu hết các mô hình thương mại hàng đầu chỉ đạt từ 2 đến 16 trên thang điểm 100 do giấu kín dữ liệu pre-training.
Sự tương phản này khẳng định vai trò vô cùng quan trọng của các dự án nguồn mở toàn vẹn (như OLMo 3 hay K2 Think): chúng không chỉ là công cụ kỹ thuật mà còn là “điểm tựa minh bạch” duy nhất giúp cộng đồng khoa học độc lập có thể kiểm toán thuật toán, phát hiện ảo giác và đánh giá an toàn AI một cách khách quan.
3. So sánh toàn diện: AI nguồn mở (Open-source) vs. AI đóng (Proprietary AI)
Sự đối lập giữa AI đóng độc quyền (Proprietary AI) và AI nguồn mở / mở trọng số (Open-source / Open-weight AI) không đơn thuần là cuộc cạnh tranh về mặt kỹ thuật, mà còn đại diện cho hai triết lý phát triển khác nhau về quyền tiếp cận, chi phí, sự kiểm soát dữ liệu và tính minh bạch.
3.1 Bảng đối chiếu tổng quan
| Tiêu chí so sánh | AI đóng độc quyền (Proprietary AI) | AI nguồn mở / Mở trọng số (Open-weight) |
| Mô hình tiếp cận & Quyền sở hữu | Độc quyền, chủ yếu cung cấp dưới dạng API đám mây hoặc giao diện lưu trữ do nhà phát triển kiểm soát (như OpenAI, Anthropic, Google). | Tự do tải về, tùy biến, triển khai trên hạ tầng riêng (như DeepSeek, Meta Llama, Alibaba Qwen, Ai2 OLMo). |
| Hiệu năng đỉnh (Frontier Performance) | Dẫn đầu ở các chỉ số kiểm thử thô, nhưng khoảng cách đang thu hẹp đáng kể (mô hình đóng hàng đầu chỉ còn dẫn trước khoảng 3,3% – 3,4%). | Đạt tốc độ bắt sát năng lực mô hình đóng nhờ các kỹ thuật suy luận và tối ưu tiên tiến (như DeepSeek-R1, GLM-5, Qwen3). |
| Chi phí & Tối ưu vận hành | Chi phí trả theo lượt truy vấn API; phụ thuộc hoàn toàn vào hạ tầng đám mây thương mại đắt đỏ. | Cắt giảm chi phí suy luận (Inference cost), chủ động tối ưu bằng cắt tỉa (pruning), lọc trùng lặp dữ liệu và tinh chỉnh nội bộ. |
| Tự chủ & Bảo mật dữ liệu | Dữ liệu người dùng phải gửi lên máy chủ bên thứ ba, tiềm ẩn rủi ro lộ rò rỉ bí mật kinh doanh và bản quyền. | Toàn quyền kiểm soát dữ liệu tại chỗ (on-premise), đáp ứng tiêu chuẩn nghiêm ngặt về Chủ quyền dữ liệu (Data Sovereignty). |
| Tính minh bạch & Kiểm toán | Mô hình “Hộp đen” (Black box); giấu kín dữ liệu huấn luyện, mã nguồn, số lượng tham số và tài nguyên tính toán. | Cung cấp trọng số và kiến trúc, cho phép cộng đồng nghiên cứu độc lập kiểm toán an toàn, định kiến và ảo giác. |
3.2 Phân tích chi tiết 4 khía cạnh trọng tâm
a. Khoảng cách hiệu năng: Sự hội tụ ở đỉnh cao (Performance Convergence)
Mặc dù các phòng thí nghiệm thương mại lớn vẫn giữ vị trí dẫn đầu ở các bài kiểm tra năng lực thô, dữ liệu thực tế từ các bảng xếp hạng uy tín (như Arena Leaderboard) cho thấy khoảng cách giữa mô hình đóng và mô hình mở đã thu hẹp rất nhanh.
- Vào tháng 5 năm 2023, mô hình đóng hàng đầu (GPT-4) vượt mô hình mở trọng số tốt nhất thời điểm đó (Vicuna-13B) tới 15,2% điểm Elo. Tuy nhiên, đến tháng 3 năm 2026, khoảng cách giữa mô hình đóng dẫn đầu (Claude Opus 4.6 với 1.503 điểm) và mô hình mở trọng số hàng đầu (GLM-5 với 1.454 điểm) đã thu hẹp xuống chỉ còn khoảng 3,4%.
- Sự xuất hiện của các mô hình mở tiên tiến như DeepSeek-R1 đã tạo ra bước ngoặt lớn khi ngắn hạn san bằng cách biệt với các mô hình đóng hàng đầu của Mỹ thông qua phương pháp Học tăng cường GRPO. Sự hội tụ này khiến lợi thế cạnh tranh dần dịch chuyển từ hiệu năng thô sang chi phí vận hành, độ tin cậy và khả năng tùy biến chuyên ngành.
b. Chi phí tính toán và Tối ưu hóa vận hành (Compute & Inference Efficiency)
Mô hình đóng thương mại đòi hỏi doanh nghiệp phải chi trả mức phí API liên tục, đồng thời đối mặt với sự biến động về chi phí khi quy mô truy vấn tăng lên. Tích lũy năng lượng và hạ tầng để phục vụ hàng triệu truy vấn hàng ngày khiến chi phí suy luận (inference cost) của các hệ thống đóng trở nên rất đắt đỏ.
Ngược lại, hệ sinh thái nguồn mở mang lại khả năng tối ưu hóa chi phí vận hành dựa trên các kỹ thuật xử lý dữ liệu và kiến trúc hiện đại:
- Các nghiên cứu cho thấy việc chú trọng lọc trùng lặp (deduplication) và chọn lọc dữ liệu chất lượng cao cho phép các mô hình mở nhỏ hơn đạt hiệu năng tương đương các mô hình đóng siêu khổng lồ.
- Ví dụ, mô hình mở OLMo 3.1 Think (32B) với khoảng 32 tỷ tham số — nhỏ hơn gần 90 lần so với các mô hình đóng 3.000 tỷ tham số — vẫn đạt kết quả cạnh tranh trên các bài kiểm tra toán học chuyên sâu như AIME 2025 nhờ chiến lược tối ưu hóa tập dữ liệu và tinh chỉnh hiệu quả.
c. Tự chủ dữ liệu, Bảo mật và Chủ quyền số (Data Sovereignty & Privacy)
Trong khảo sát rủi ro AI của doanh nghiệp, có tới 63% tổ chức coi vi phạm sở hữu trí tuệ (IP infringement) và rò rỉ dữ liệu riêng tư là những rào cản hàng đầu khi ứng dụng AI. Việc sử dụng mô hình đóng buộc người dùng phải truyền gửi dữ liệu qua các API trung gian, tạo ra nguy cơ phụ thuộc vào các thể chế công nghệ bên ngoài.
Mô hình nguồn mở và mở trọng số giải quyết triệt để bài toán này bằng cách cho phép triển khai hoàn toàn nội bộ (on-premise) hoặc trên đám mây riêng:
- Doanh nghiệp giữ toàn bộ quyền kiểm soát đối với dữ liệu nhạy cảm, sở hữu trí tuệ và mã nguồn kinh doanh.
- Đáp ứng trọn vẹn các quy định khắt khe về Chủ quyền dữ liệu (Data Sovereignty) và luật bảo vệ quyền riêng tư (như GDPR).
d. Thách thức “Hộp đen” vs. Yêu cầu Minh bạch (Black-box vs. Transparency)
Sự gia tăng thương mại hóa khiến các mô hình đóng hàng đầu ngày càng trở nên khép kín. Báo cáo AI Index ghi nhận có tới 81 trong số 102 mô hình nổi bật năm 2025 được phát hành mà không công khai mã nguồn huấn luyện. Điểm số trung bình trên Chỉ số Minh bạch Mô hình Nền tảng (FMTI) của các tập đoàn lớn đã giảm mạnh từ 58 xuống còn 40, trong khi Chỉ số Openness Index đánh giá hầu hết các mô hình đóng thương mại chỉ đạt từ 2 đến 16 trên thang điểm 100.
Sự “mù mờ” của các mô hình đóng cản trở khả năng tái lập nghiên cứu, kiểm toán độ an toàn và đánh giá ảo giác (hallucination) từ bên thứ ba. Trong bối cảnh đó, các mô hình nguồn mở toàn vẹn cung cấp đầy đủ trọng số, kiến trúc và tập dữ liệu huấn luyện, đóng vai trò là chuẩn mực duy nhất để cộng đồng khoa học độc lập thực hiện kiểm toán kỹ thuật, phát hiện định kiến và xây dựng các rào cản an toàn có trách nhiệm.
4. Vai trò thúc đẩy đổi mới sáng tạo và dân chủ hóa công nghệ
4.1 Xóa bỏ rào cản gia nhập cho doanh nghiệp vừa và nhỏ (SMEs) và các nước đang phát triển
Một trong những giá trị cốt lõi nhất của AI nguồn mở là khả năng phá vỡ thế độc quyền tài nguyên tính toán và tri thức do các tập đoàn công nghệ lớn nắm giữ. Để huấn luyện một mô hình nền tảng tiên phong (frontier model) từ đầu, các doanh nghiệp phải đầu tư hàng trăm triệu USD cho hạ tầng GPU/TPU, trung tâm dữ liệu và nguồn năng lượng khổng lồ. Đây là rào cản tài chính gần như không thể vượt qua đối với các doanh nghiệp vừa và nhỏ (SMEs), công ty khởi nghiệp hay các viện nghiên cứu ở những quốc gia đang phát triển.
Hệ sinh thái AI nguồn mở và mở trọng số (open weights) đã tái định hình bài toán kinh tế này:
- Tái sử dụng tri thức sẵn có: Nhờ các mô hình mở trọng số như Meta Llama, DeepSeek, Alibaba Qwen hay AI21 OLMo, các tổ chức có thể kế thừa trực tiếp kết quả huấn luyện hàng nghìn tỷ token mà không cần tốn chi phí xây dựng hạ tầng ban đầu.
- Tối ưu hóa chi phí tinh chỉnh (Fine-tuning): Thay vì chi trả mức phí API đám mây liên tục và biến động, doanh nghiệp có thể áp dụng các kỹ thuật tinh chỉnh chuyên biệt trên hạ tầng nội bộ (on-premise) hoặc điện toán đám mây riêng.
- Thúc đẩy hệ sinh thái khởi nghiệp toàn cầu: Dữ liệu từ GitHub cho thấy sự gia tăng đóng góp mã nguồn AI từ các khu vực phát triển ngoài Mỹ và Châu Âu, với sự tham gia ngày càng lớn của các nhà phát triển tại Ấn Độ, Đông Nam Á và Nam Mỹ. Nhờ đó, hàng nghìn ứng dụng AI chuyên ngành trong tài chính, tư vấn pháp lý, logistics và giáo dục đã ra đời với chi phí R&D tối ưu.
4.2 Thu hẹp “Khoảng cách Ngôn ngữ & Văn hóa toàn cầu” (Global Language Gap)
Mặc dù các mô hình thương mại đóng hàng đầu đạt hiệu năng rất cao trên các bài kiểm tra tiếng Anh, chúng đối mặt với thách thức lớn về “khoảng cách ngôn ngữ toàn cầu” (Global Language Gap) khi áp dụng vào các ngôn ngữ ít tài nguyên hoặc biến thể địa phương. Do dữ liệu huấn luyện chủ yếu tập trung vào tiếng Anh và một số ngôn ngữ phổ biến, các mô hình toàn cầu thường gặp hiện tượng suy giảm hiệu năng, thiếu nhạy cảm văn hóa hoặc phản ánh thiên vị ngữ cảnh.
Hệ sinh thái nguồn mở đã trở thành công cụ đắc lực để các quốc gia và cộng đồng tự bảo tồn bản sắc văn hóa và xây dựng hạ tầng ngôn ngữ bản địa:
- Xử lý ngôn ngữ vùng miền và tiếng địa phương: Báo cáo Stanford AI Index ghi nhận nhiều mô hình toàn cầu bị giảm tới gần một nửa độ chính xác khi đánh giá trên bài kiểm thử suy luận tiếng địa phương (như biến thể Slovenian Cerkno trên Slobench). Ngược lại, các mô hình nguồn mở được huấn luyện riêng cho vùng miền giúp duy trì độ chính xác cao đối với ngữ pháp, phương ngữ và hiện tượng chuyển đổi ngôn ngữ (code-switching).
- Các sáng kiến ngôn ngữ khu vực tiêu biểu:
- Đông Nam Á: Dự án SEA-LION và bộ kiểm thử SEA-HELM (phát triển cho tiếng Việt, Thái Lan, Indonesia, Filipino, Tamil) cùng bộ kiểm thử BATAYAN (tiếng Tagalog và Taglish) giúp đánh giá toàn diện năng lực ngôn ngữ và văn hóa khu vực.
- Ấn Độ: Sáng kiến AI4Bharat tại IIT Madras xây dựng nền tảng Indic LLM Arena, đánh giá các mô hình trên hơn 20 ngôn ngữ Ấn Độ về chất lượng ngôn ngữ, sự thấu hiểu văn hóa và tính an toàn.
- Khu vực Ả Rập & Châu Âu: Hệ sinh thái HELM Arabic (với các mô hình như LLM-X hay Jais) cùng các dự án IberoBench (Tây Ban Nha, Bồ Đào Nha, Basque, Catalan), BenCzechMark (Tiếng Séc) hay ITALIC (Tiếng Ý) đảm bảo rằng AI phục vụ chính xác bối cảnh lịch sử và văn hóa địa phương.
Sự chủ động phát triển các mô hình nguồn mở bản địa khẳng định nguyên tắc: tính bao hàm ngôn ngữ không phải là tính năng bổ sung thụ động, mà là yêu cầu thiết kế tiên quyết của một hệ sinh thái AI có trách nhiệm.
4.3 Giải phóng Tri thức Khoa học mở (Open Science & Bio-AI)
Trong khi lĩnh vực AI tạo sinh thương mại do khu vực tư nhân chiếm ưu thế, bức tranh AI trong nghiên cứu khoa học thuần túy (Scientific AI) chứng kiến sự áp đảo của mô hình hợp tác nguồn mở phi lợi nhuận từ các viện hàn lâm và tổ chức nghiên cứu quốc tế.
AI nguồn mở đang đóng vai trò là hạ tầng đẩy nhanh các phát minh khoa học trong y học, sinh học di truyền và vật lý:
- Mô hình Tế bào ảo & Sinh học di truyền (Bio-AI): Các mô hình nguồn mở quy mô lớn như CellFM (được huấn luyện trên dữ liệu phiên mã của 100 triệu tế bào người) hay Evo 2 cho phép mô phỏng chính xác các tương tác sinh học phức tạp. Trong lĩnh vực dự đoán cấu trúc protein và thiết kế thuốc, các mô hình mở như OpenFold3, Boltz-1 / Boltz-2 hay OpenCRISPR-1 (được phát triển từ mô hình ProGen 6B) cho phép các nhà khoa học toàn cầu tự do thiết kế các protein và enzyme mới mà không bị ràng buộc bởi bản quyền thương mại độc quyền.
- Khoa học Vật lý, Hóa học và Trái đất: Các mô hình nền tảng mở như AION-1 (chuyên sâu thiên văn học với dữ liệu từ 200 triệu thiên thể), ChemDFM hay tập dữ liệu hóa học mở ChemPile (250GB dữ liệu hóa học) cung cấp công cụ tự do cho cộng đồng nghiên cứu vật liệu mới, mô phỏng phản ứng hóa học và dự báo biến đổi khí hậu.
Việc công khai mã nguồn, tập dữ liệu và trọng số trong nghiên cứu khoa học giúp củng cố nguyên tắc tái lập nghiên cứu (reproducibility), ngăn ngừa sự thao túng tri thức và đảm bảo rằng những phát minh mang tính sống còn của nhân loại được tiếp cận một cách bình đẳng.
5. Rủi ro an ninh và thách thức trong kiểm soát AI nguồn mở
Mặc dù AI nguồn mở và mở trọng số (open-weight) mang lại những lợi ích to lớn cho sự bình đẳng công nghệ và đổi mới sáng tạo, tính cởi mở này cũng đồng thời tạo ra những kẽ hở an ninh và thách thức quản trị phức tạp. Khi trọng số mô hình được phân phối tự do, rào cản kỹ thuật bị xóa bỏ không chỉ cho các nhà nghiên cứu chân chính mà còn cho cả các tác nhân có ý đồ xấu.
5.1 Nguy cơ lạm dụng mục đích kép (Dual-use & Malicious Misuse)
Khác với các mô hình đóng thương mại được bảo vệ bởi lớp lọc kiểm duyệt tập trung trên đám mây (API-level guardrails), các mô hình mở trọng số cho phép người dùng toàn quyền can thiệp vào cấu trúc và tham số nội tại. Điều này dẫn đến nguy cơ bị lạm dụng cho các mục đích nguy hiểm:
- Dễ dàng loại bỏ hàng rào an toàn (Jailbreaking & Fine-tuning removal): Kẻ xấu có thể sử dụng các kỹ thuật tinh chỉnh (fine-tuning) hoặc hủy bỏ bộ lọc (unlearning bypass) để vô hiệu hóa các quy tắc đạo đức do nhà phát triển thiết lập ban đầu. Đánh giá từ bộ kiểm thử AILuminate cho thấy: dưới điều kiện sử dụng thông thường, đa số mô hình đạt mức an toàn “Tốt” (Good) hoặc “Rất tốt” (Very Good); tuy nhiên, khi bị tấn công đối kháng (adversarial prompts/jailbreak), điểm số an toàn của tất cả các mô hình đều suy giảm nghiêm trọng.
- Tự động hóa tấn công mạng và phát tán mã độc: Các mô hình mở trọng số có năng lực lập trình cao có thể bị lợi dụng để tự động hóa kịch bản lừa đảo (phishing), quét tìm lỗ hổng phần mềm hoặc tạo ra các đoạn mã độc tinh vi. Các bộ kiểm thử an ninh mạng như Cybench hay HarmBench được xây dựng nhằm đo lường và cảnh báo nguy cơ này.
- Nguy cơ an ninh sinh – hóa học (WMDP – Weapons of Mass Destruction): Sự gia tăng năng lực của AI trong khoa học sự sống tạo ra rủi ro lạm dụng để thiết kế các tác nhân sinh học hoặc độc tố hóa học nguy hiểm. Bộ kiểm thử WMDP được thiết lập nhằm đo lường tri thức nguy hiểm và thúc đẩy các kỹ thuật “quên tri thức độc hại” (unlearning) trước khi công khai trọng số mô hình ra cộng đồng.
- Bùng nổ tin giả, Deepfake và lừa đảo quy mô lớn: Việc thiếu bộ lọc trung tâm khiến các mô hình nguồn mở dễ bị lợi dụng để sản xuất nội dung giả mạo hàng loạt. Các vụ việc thực tế như lừa đảo deepfake mạo danh (vụ việc diễn viên Jin Dong tại Trung Quốc) hay giả mạo giao diện website doanh nghiệp để đánh cắp thông tin thẻ tín dụng cho thấy công nghệ tạo sinh đang hạ thấp chi phí thực hiện các hành vi tội phạm kỹ thuật số.
5.2 Bài toán Quy trách nhiệm và Quản trị Pháp lý (Governance & Accountability)
Sự phân tán của hệ sinh thái nguồn mở đang đặt ra câu hỏi hóc húa cho các cơ quan quản lý: Ai sẽ chịu trách nhiệm khi một mô hình nguồn mở gây ra thiệt hại thực tế?
- Rủi ro “Không thể thu hồi” (Un-ring the bell): Một khi trọng số mô hình nguồn mở đã được tải lên các kho lưu trữ công khai (như GitHub hay Hugging Face) và phát tán trên Internet, việc thu hồi hoặc ngăn chặn truy cập là điều hoàn toàn không thể.
- Sự khoảng trống về chủ thể chịu trách nhiệm pháp lý: Ranh giới trách nhiệm giữa nhà phát triển ban đầu (người tạo ra trọng số gốc) và bên tinh chỉnh/triển khai (người sửa đổi và vận hành mô hình) hiện vẫn chưa được phân định rõ ràng trong nhiều hệ thống pháp luật.
- Thách thức tuân thủ khung pháp lý toàn cầu: Các quy định khắt khe như Đạo luật AI của Liên minh Châu Âu (EU AI Act) đặt ra các nghĩa vụ minh bạch và đánh giá rủi ro hệ thống đối với các mô hình nền tảng (General-Purpose AI). Việc thực thi các luật định này — cùng các tiêu chuẩn như NIST AI RMF, ISO/IEC 42001 hay Đạo luật Take It Down Act của Mỹ — đối với các mô hình chạy cục bộ (on-premise) không qua đám mây thương mại đòi hỏi các phương pháp kiểm toán hoàn toàn mới.
5.3 Thách thức đánh đổi giữa Tính cởi mở (Openness) và Tính an toàn (Safety)
Việc phát triển AI nguồn mở buộc cộng đồng khoa học phải liên tục giải bài toán đánh đổi phức tạp giữa mong muốn chia sẻ tri thức minh bạch và yêu cầu đảm bảo an ninh.
- Xung đột giữa Đổi mới tự do và An toàn phi đối xứng: Sự cởi mở giúp thúc đẩy nghiên cứu độc lập và củng cố niềm tin công cộng, nhưng đồng thời tạo ra “lợi thế bất cân xứng” cho kẻ tấn công (attackers) so với bên phòng thủ (defenders) khi kiến trúc và điểm yếu của mô hình bị công khai hoàn toàn.
- Sự mâu thuẫn nội tại giữa các chiều kích AI Trách nhiệm (RAI Trade-offs): Các nghiên cứu thực nghiệm ghi nhận hiện tượng đánh đổi kỹ thuật giữa các mục tiêu an toàn: việc gia tăng một chiều kích có thể làm suy giảm chiều kích khác.
- Sự đổi mới giữa Quyền riêng tư và Độ chính xác: Việc áp dụng kỹ thuật Bảo mật vi phân (Differential Privacy) để ngăn rò rỉ dữ liệu cá nhân có thể làm giảm độ chính xác của mô hình lên tới 33 percentage points.
- Tác động tiêu cực đến tính công bằng: Khi gia tăng bảo mật vi phân trong mô hình học liên kết (Federated Learning), khả năng nhận diện của mô hình đối với các nhóm dữ liệu nhỏ (từ các viện nghiên cứu hoặc bệnh viện ít tài nguyên) bị suy giảm nghiêm trọng hơn so với các đơn vị lớn.
- Yêu cầu xây dựng rào cản an toàn tự thân (In-model Safety): Thay vì trông chờ vào bộ lọc đám mây bên ngoài, hệ sinh thái nguồn mở đòi hỏi việc tích hợp trực tiếp các cơ chế tự vệ kỹ thuật (như alignment qua học tăng cường, công cụ tự phát hiện ảo giác HHEM/AA-Omniscience, và quy trình loại bỏ tri thức độc hại WMDP) ngay trong giai đoạn huấn luyện mô hình.
6. Hướng tới một hệ sinh thái AI nguồn mở cân bằng và bình đẳng
6.1 Tóm lược luận điểm cốt lõi
Sự phát triển bứt phá của Trí tuệ nhân tạo (AI) đã đưa toàn cầu đến một điểm uốn lịch sử, nơi cuộc cạnh tranh công nghệ không chỉ dừng lại ở quy mô hạ tầng tính toán hay hiệu năng thuật toán, mà còn định hình lại trật tự tiếp cận tri thức của nhân loại. Qua các phân tích chuyên sâu, có thể rút ra ba kết luận cốt lõi:
- AI nguồn mở là trụ cột bình đẳng công nghệ: Bản chất của AI nguồn mở và mở trọng số (open-weight) vượt xa một phương thức chia sẻ mã nguồn kỹ thuật. Với hơn 5,58 triệu dự án AI trên GitHub và hàng trăm nghìn mô hình được chia sẻ trên các nền tảng cộng đồng, nguồn mở đã trở thành động lực duy nhất giúp san bằng rào cản gia nhập cho doanh nghiệp vừa và nhỏ (SMEs), hỗ trợ các nước đang phát triển xây dựng năng lực nội địa, thu hẹp “khoảng cách ngôn ngữ toàn cầu” (Global Language Gap) và bảo tồn đa dạng văn hóa bản địa.
- Khoảng cách hiệu năng thu hẹp nhưng tính minh bạch suy giảm: Các dữ liệu thực nghiệm ghi nhận sự hội tụ năng lực mạnh mẽ giữa mô hình mở trọng số và mô hình đóng thương mại. Mặc dù các mô hình đóng vẫn giữ vị trí dẫn đầu ở một số bài kiểm tra thô, các mô hình mở tiên tiến (như DeepSeek-R1, Qwen3 hay OLMo 3 Think) đã bám đuổi sát nút với chi phí vận hành tối ưu hơn rất nhiều. Tuy nhiên, sự thương mại hóa khiến các mô hình đóng hàng đầu ngày càng trở thành những “hộp đen” khép kín — điểm số trung bình trên Chỉ số Minh bạch Mô hình Nền tảng (FMTI) đã giảm mạnh từ 58 xuống còn 40, trong khi đa số mô hình tiên phong nhận điểm số rất thấp (từ 2 đến 16/100) trên Chỉ số Mở (Openness Index) do giấu kín dữ liệu huấn luyện.
- Thách thức an ninh và khoảng trống quản trị: Tính cởi mở của nguồn mở mang lại sự do đổi mới, nhưng cũng đối mặt với nguy cơ lạm dụng mục đích kép (dual-use), loại bỏ rào cản an toàn (jailbreak), tự động hóa tấn công mạng và phát tán thông tin giả mạo. Trong bối cảnh số lượng sự cố AI được ghi nhận tăng vọt lên 362 vụ, việc quản trị các mô hình nguồn mở phân tán đòi hỏi các giải pháp vượt thoát khỏi cơ chế kiểm duyệt đám mây truyền thống.
6.2 Định hướng chiến lược: Xây dựng hệ sinh thái AI nguồn mở có trách nhiệm
Để AI nguồn mở phát huy tối đa vai trò dân chủ hóa công nghệ mà vẫn đảm bảo an toàn hệ thống, cộng đồng công nghệ, các tập đoàn và chính phủ cần phối hợp thực hiện các định hướng chiến lược sau:
a. Xây dựng cơ chế “Quản trị Nguồn mở có Trách nhiệm” (Responsible Open-Source Governance)
- Tích hợp an toàn tự thân (In-model Safety): Thay vì phụ thuộc vào bộ lọc API bên ngoài, các nhà phát triển mô hình nguồn mở cần chủ động tích hợp cơ chế tự vệ kỹ thuật ngay từ giai đoạn huấn luyện (pre-training) và tinh chỉnh (post-training). Áp dụng các phương pháp “quên tri thức nguy hiểm” (unlearning) đối với các dữ liệu độc hại, vũ khí sinh-hóa học (WMDP) và mã độc mạng trước khi công khai trọng số mô hình ra cộng đồng.
- Thúc đẩy kiểm toán và tiêu chuẩn đánh giá cộng đồng: Khuyến khích sự tham gia của các tổ chức nghiên cứu độc lập trong việc kiểm toán định kỳ tính công bằng, độ tin cậy và ảo giác (hallucination) của các mô hình mở thông qua các bộ kiểm thử tiêu chuẩn như AILuminate, HELM Safety hay AA-Omniscience.
b. Thúc đẩy hợp tác Công – Tư và đầu tư hạ tầng tính toán dùng chung
- Xác lập “Chủ quyền AI” (AI Sovereignty) dựa trên nguồn mở: Các quốc gia đang phát triển cần đầu tư xây dựng các trung tâm tính toán hiệu năng cao (supercomputing clusters) và hạ tầng dữ liệu sạch công cộng. Việc này cho phép các nhà khoa học và doanh nghiệp nội địa tinh chỉnh các mô hình mở trọng số phục vụ các lĩnh vực thiết yếu như y tế, giáo dục và quản lý hành chính công mà không lo rò rỉ dữ liệu riêng tư.
- Khuyến khích mô hình liên minh nghiên cứu phi lợi nhuận: Mở rộng các hợp tác công – tư (Public-Private Partnerships) tương tự như các dự án Bio-AI và Scientific AI mở (như OpenFold3, Boltz-2, OLMo Earth), đảm bảo rằng các phát minh mang tính sống còn của nhân loại được chia sẻ công khai và phục vụ lợi ích chung.
c. Hoàn thiện khung pháp lý và cân bằng giữa Cởi mở (Openness) & An toàn (Safety)
- Chuyển dịch sang các tiêu chuẩn quản trị kỹ thuật: Cập nhật và áp dụng linh hoạt các tiêu chuẩn quản lý AI quốc tế như ISO/IEC 42001 (đã được 36% tổ chức áp dụng) và Khung quản lý rủi ro NIST AI RMF (33% tổ chức áp dụng), bên cạnh các luật định chuyên biệt như EU AI Act.
- Phân định rõ ràng trách nhiệm pháp lý: Xây dựng khung pháp lý phân biệt rõ trách nhiệm giữa nhà phát triển trọng số gốc và bên trực tiếp tinh chỉnh/triển khai ứng dụng, tránh việc thắt chặt quản lý quá mức làm triệt tiêu động lực sáng tạo của cộng đồng nguồn mở
AI nguồn mở không phải là một mối đe doạ đối với sự an toàn, mà là điều kiện tiên quyết để xây dựng một tương lai công nghệ bình đẳng và minh bạch. Trong một thế giới mà AI đang trở thành hệ điều hành của nền văn minh số, việc giữ cho công nghệ này cởi mở, có thể kiểm toán và tiếp cận bình đẳng chính là rào cản vững chắc nhất chống lại sự độc quyền tri thức, xói mòn đa dạng văn hóa và bất bình đẳng kinh tế toàn cầu. Một hệ sinh thái AI nguồn mở được quản trị có trách nhiệm sẽ là chìa khóa để đảm bảo rằng quyền năng của trí tuệ nhân tạo luôn phục vụ và nâng tầm toàn thể nhân loại.






0 Lời bình